博弈论现实决策方法的起点是把相互依赖写成模型:谁是参与者,各自有哪些策略,知道什么,何时行动,怎样评价结果。模型可以帮助检查最佳回应、稳定性与合作条件,但结论只在这些假设内成立。
本文先比较一本非数学策略通识和一部进阶决策支持文集,再用本站原创的 2×2 假设矩阵说明最佳回应、纯策略纳什均衡和“每个人都更偏好”的结果为什么不是同一概念。
博弈论现实决策方法:先写参与者、策略与信息
在画收益矩阵前,先回答五个问题:
- 参与者:哪些人的选择会相互影响?
- 策略:每人实际可以选择什么?是否同时行动?
- 信息:每人知道哪些规则、历史和对方信息?
- 偏好:每人怎样比较自己的结果?点数代表什么顺序?
- 互动:这是一次还是重复发生,能否沟通、承诺或形成声誉?
MIT OpenCourseWare 的博弈论讲义用参与者、策略与收益表示战略互动,并把最佳回应定义为对方策略给定时的选择。现实问题只有在这些对象和假设足够清楚时,才适合使用相应模型。
两本书分别适合通识和进阶建模
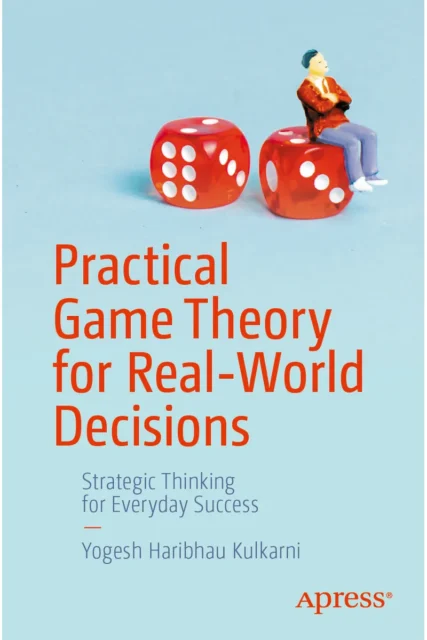
日常策略通识:《实战博弈论》
《实战博弈论:现实世界决策》的作者是 Yogesh Haribhau Kulkarni,Anand Kolharkar 是技术审校者。前言明确面向不想处理公式、图解或典型收益矩阵计算的普通读者,目录覆盖基础概念、囚徒困境、合作、序贯/同时博弈、信号、信息不对称、议价和社会困境。
想先建立策略语言,可以用这本书识别参与者、相互依赖、信息和承诺,再把日常案例改写成明确假设。本文下面的矩阵和 Python 代码是本站原创补充,不是书中案例,也不表示该书包含代码或收益矩阵练习。
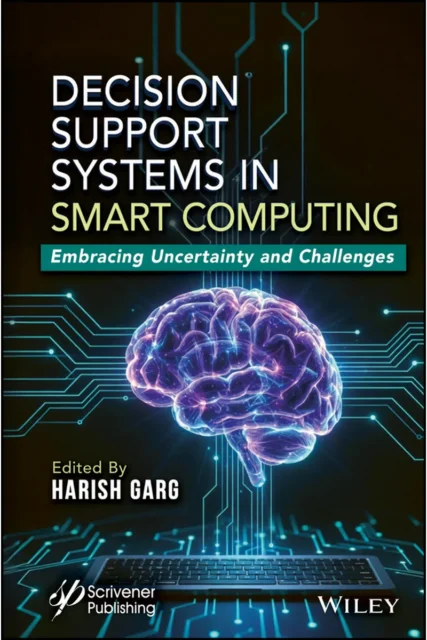
不确定性与多准则方法:《智能计算中的决策支持系统》
《智能计算中的决策支持系统》由 Harish Garg 主编,是多作者研究章节集。目录和开篇包含模糊集、线性规划、多目标优化、MCDM 以及供应链、环境、医疗和城市等领域方法。
它适合能够阅读公式、方法假设和章节局限,并且确实需要不确定性、多准则或优化模型的读者。它不是普通博弈论读者天然要接着读的“下一本”,应按具体决策问题查阅。
博弈论收益矩阵入门:一个原创假设模型
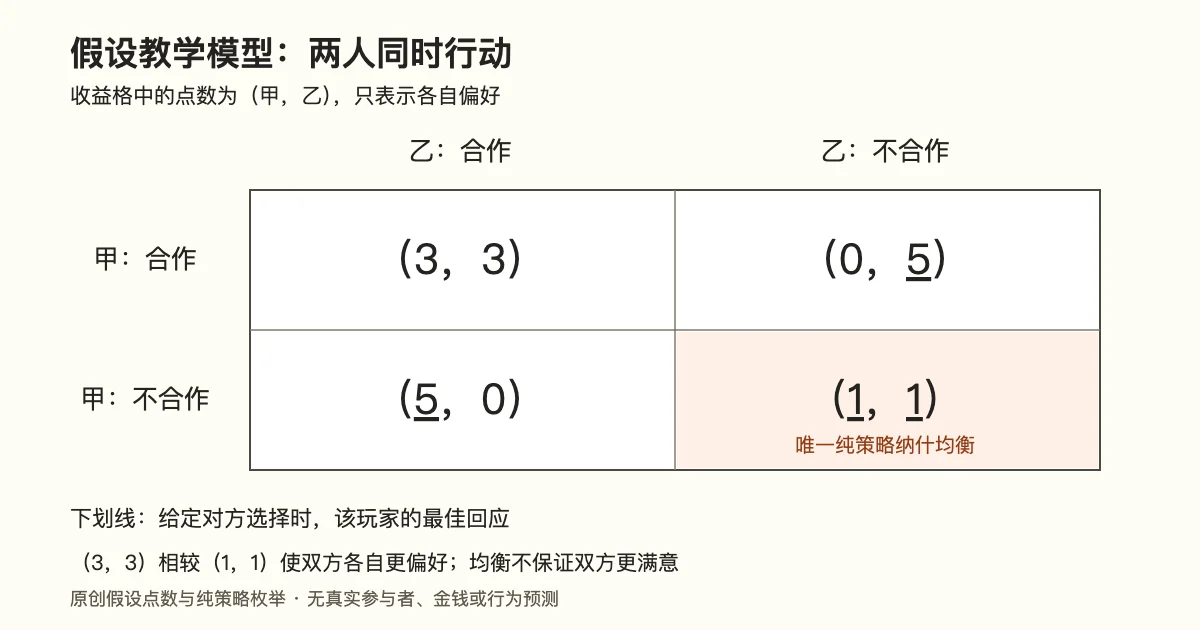
假设甲、乙在一次、同时、完全信息的互动中,各自选择合作 C 或不合作 D。这里的“完全信息”指双方知道参与者、选项和收益设定;同时行动时,不会先看到对方本轮的选择。表中每个括号依次写甲、乙的点数。点数只表示各人自己的序数偏好,不是金钱,也不能把两人的点数相加后当作社会价值。下划线标出给定对方选择时,各自的最佳回应。
| 甲 \ 乙 | 合作 C | 不合作 D |
|---|---|---|
| 合作 C | (3, 3) | (0, 5) |
| 不合作 D | (5, 0) | (1, 1) |
最佳回应与唯一纯策略纳什均衡
如果乙选 C,甲选 D 得 5 点,高于选 C 的 3 点;如果乙选 D,甲选 D 得 1 点,高于选 C 的 0 点。乙的比较完全对称。因此,在这张固定矩阵里,D 是双方的严格优势策略,(D,D) 是唯一纯策略纳什均衡。
MIT 关于纳什均衡的说明强调:在其他参与者策略给定时,均衡中的任何参与者都不会通过单方面改变策略而变得更好。这是条件性的稳定概念,不是现实中必然出现的结果。
稳定结果与每人更偏好的结果
在 (C,C) 中,甲和乙各得 3 点;在 (D,D) 中,各得 1 点。两个人分别都更偏好 (C,C),但如果对方保持 C,自己从 C 改为 D 就会从 3 点变成更偏好的 5 点,产生单方偏离激励。相反,(D,D) 没有单方偏离激励,却存在双方一起改变选择后各自都更偏好的 (C,C)。
Stanford Encyclopedia of Philosophy 的博弈论条目也用囚徒困境说明,纳什稳定状态不必是帕累托意义下的理想结果。这里不需要把甲乙点数跨人相加;只需分别比较每个人在两个结果中的偏好。
查看本站原创纯策略枚举代码
"""Artificial preference points; enumerate a two-player pure-strategy model.
No observed participants, money, repeated play, data fitting or real decisions.
Each tuple is (row player A's points, column player B's points).
"""
import json

STRATEGIES = ('cooperate', 'defect')
PAYOFFS = {
    ('cooperate', 'cooperate'): (3, 3),
    ('cooperate', 'defect'): (0, 5),
    ('defect', 'cooperate'): (5, 0),
    ('defect', 'defect'): (1, 1),
}


def best_responses_to_b(b):
    maximum = max(PAYOFFS[(a, b)][0] for a in STRATEGIES)
    return [a for a in STRATEGIES if PAYOFFS[(a, b)][0] == maximum]


def best_responses_to_a(a):
    maximum = max(PAYOFFS[(a, b)][1] for b in STRATEGIES)
    return [b for b in STRATEGIES if PAYOFFS[(a, b)][1] == maximum]


def analyze():
    best_a = {b: best_responses_to_b(b) for b in STRATEGIES}
    best_b = {a: best_responses_to_a(a) for a in STRATEGIES}
    equilibria = [(a, b) for a in STRATEGIES for b in STRATEGIES
                  if a in best_a[b] and b in best_b[a]]
    mutual_cooperation = PAYOFFS[('cooperate', 'cooperate')]
    mutual_defection = PAYOFFS[('defect', 'defect')]
    both_prefer_cc_to_dd = all(c > d for c, d in zip(mutual_cooperation, mutual_defection))
    return {'best_responses_a_given_b': best_a, 'best_responses_b_given_a': best_b,
            'pure_strategy_nash': equilibria, 'both_prefer_cc_to_dd': both_prefer_cc_to_dd}


if __name__ == '__main__':
    result = analyze()
    assert set(PAYOFFS) == {(a, b) for a in STRATEGIES for b in STRATEGIES}
    assert all(PAYOFFS[('defect', b)][0] > PAYOFFS[('cooperate', b)][0] for b in STRATEGIES)
    assert all(PAYOFFS[(a, 'defect')][1] > PAYOFFS[(a, 'cooperate')][1] for a in STRATEGIES)
    assert result['pure_strategy_nash'] == [('defect', 'defect')]
    assert result['both_prefer_cc_to_dd']
    print(json.dumps(result, ensure_ascii=False, indent=2))
代码在 Python 3.9.6 中枚举四个纯策略组合,完成五项断言:四个组合齐全;甲在乙选 C 或 D 时都以 D 为最佳回应;乙同理;唯一纯策略纳什均衡是 (D,D);两人分别都更偏好 (C,C) 而非 (D,D)。这是固定矩阵的枚举结果,没有实际参与者或行为实验。
合作与竞争判断框架:先检查哪些假设会改变结论
博弈论日常决策案例要先写成待核假设
若要把日常合作情境写成模型,应先把“合作”和“不合作”对应到明确行动,再询问各方如何评价结果、是否知道对方选项、能否沟通、互动是否重复,以及声誉和制度是否改变未来收益。这些偏好和信息需要调查或说明,不能从教学矩阵直接搬过去。
例如,“双方都有长期合作关系”只是一个待核条件。它可能改变策略空间、信息和未来收益,却不自动保证合作;同样,一次互动中的均衡也不能直接预测重复互动。
博弈论适用限制:何时需要换模型或补证据
- 参与者或策略变了:重新定义模型,不能沿用原矩阵。
- 信息不完全:需要记录各方知道什么、相信什么,可能要换用相应模型。
- 互动会重复:历史、承诺、惩罚和声誉可能进入收益与策略。
- 收益未知:先收集偏好和结果证据,不用任意点数代替现实。
- 目标是因果或预测:博弈结构还要结合数据、研究设计和领域知识。
需要核对数据、指标和因果边界时,可参考数据分析决策书籍的指标与证据卡;需要建立更通用的概念—证据—假设阅读方法,可从科学与思维阅读路线进入。
用四个问题决定下一步阅读
- 我能否写清参与者、策略、信息和偏好吗?不能时先读《实战博弈论》的基础与案例章节。
- 我需要的是战略相互依赖,还是模糊、多准则或优化方法?后者才考虑按问题查阅决策支持系统文集。
- 结论依赖哪些模型假设?把一次/重复、同时/序贯、完全/不完全信息写清。
- 还缺什么现实证据?记录偏好、行为、制度、数据和领域解释。
本文于 2026 年 11 月 9 日核对资料。书目事实来自两本授权 EPUB 的扉页、版权、前言、目录及必要开篇章节,未完整通读,也未验证书中案例。原创矩阵与代码只分析一个人工设定的一次、同时、完全信息纯策略模型,没有真实参与者、金钱、重复互动、数据拟合或现实策略优化。