选择数据分析决策书籍,先判断自己要补哪一层能力:需要读懂分母、样本、分布和相关关系,先补统计语言;需要和数据团队讨论问题、项目、模型与风险,选择管理者数据科学读物;需要阅读模糊决策、多目标优化等研究模型,再进入研究型决策支持系统文集。同一个业务问题可以在三层形成不同产出。
本文用“是否扩大某项服务改版”作为贯穿问题,比较三本书能帮助管理者完成什么,并提供一组可复算的手工假想计数。重点是把指标口径、组成变化、数据质量和决策责任写清楚。
管理者数据素养阅读:同一问题的三种深度
管理者数据素养阅读不等于亲自完成所有建模工作。管理者至少要能说明业务问题、指标定义、数据来源、比较条件、关键假设和仍然未知的部分,再与分析人员讨论下一项证据。
| 阅读深度 | 针对“是否扩大服务改版”的产出 | 对应主读 |
|---|---|---|
| 统计概念 | 指标卡:分子、分母、分群、时间、样本与推断范围 | 《精通统计学》 |
| 数据项目管理 | 沟通简报:问题、数据、方法、模型风险、负责人和下一项分析 | 《面向决策者的数据科学》 |
| 研究型决策模型 | 模型阅读卡:目标、约束、不确定性、方法、输入和适用范围 | 《智能计算中的决策支持系统》 |
若业务问题和受影响者尚未明确,可先用商业管理阅读路线的问题—证据工作单界定任务。进入数据阅读后,再把每个数字放回定义和使用情境。
数据科学与决策方法:三本书分别补什么
统计语言基础:《精通统计学》
可核对事实:Thomas Nield 的《精通统计学:面向初学者的友好指南》面向商业分析师、电子表格或 SQL 使用者、研究人员、顾问、企业领导者和转向机器学习的软件工程师。书中建议先按第 1–5 章学习数据、概率、分布和样本;多数代码使用 Python 3。后续目录进入显著性、相关与回归。随书版权页标注 2027,本文不据此判断当前市场版本状态。
编辑判断:需要读懂业务比率、样本和统计主张时,可以先完成第 1–5 章的概念阅读,产出一张指标卡。若还要复算代码,再单独准备 Python 环境和输入数据;概念阅读与代码实践可以分开安排。
管理者与数据团队的桥梁:《面向决策者的数据科学》
可核对事实:Jon Howells 的《面向决策者的数据科学》前言面向高管、经理和走向领导岗位的数据科学家,说明无需正式统计或机器学习背景,基础代数、概率和统计会有帮助。目录从数据类型、探索性分析、显著性和回归进入机器学习风险、项目与团队;第 3 章及部分练习使用 Python 和 Google Colab。
编辑判断:如果目标是与数据团队共同界定问题、理解分析和管理项目,这本书适合作为桥梁。读后简报可以包括:业务决定、数据来源、模型或分析方法、关键假设、不能回答的问题、负责人和下一次评估。
研究型模型阅读:《智能计算中的决策支持系统》
可核对事实:《智能计算中的决策支持系统》由 Harish Garg 主编,是多作者研究章节集。第一章已经使用模糊集、线性规划、多目标优化和数学定义,后续章节涉及供应链、环境、智慧城市、医疗、教育与公共服务等领域。
编辑判断:它适合能够阅读模型定义、目标、约束、假设和局限的读者,用来了解研究型决策支持方法。面对具体章节时,先制作模型阅读卡,再判断其输入、目标函数和不确定性表示是否与当前业务问题相符。
用数据支持业务决策:先写完整指标定义
用数据支持业务决策时,第一步是把指标写成可以复核的定义。英国 ONS 将统计质量解释为是否适合用途,并列出相关性、准确性与可靠性、及时性、可访问性与清晰度、连贯性与可比性等维度。ONS 的质量框架可以借来检查业务数据是否适合当前问题,它不是企业必须采用的合规清单。
美国 Census Bureau 的统计质量标准 E1(官方 PDF)要求分析说明问题、来源、变量、采集与处理、局限、方法和关键假设,并在适用时考虑缺失、异常、偏差、抽样设计、权重和不确定性。本文借用这些维度完善指标卡,不把 Census 信息产品标准直接当作企业制度。
业务指标与统计误区:先看分母和分群
| 指标字段 | 必须写清的内容 | 需要追问的误读 |
|---|---|---|
| 分子、分母与单位 | 按事件、用户、订单、金额或时间怎样计数 | 分母改变后,百分比还能直接比较吗? |
| 人群与分群 | 包括或排除谁,哪些组别影响汇总 | 总体数是否隐藏了组成变化? |
| 时间与版本 | 窗口、时点、抽取版本和定义变更 | 是否在比较不同季节、规则或版本? |
| 质量与不确定性 | 来源、缺失、异常、样本、权重、误差和假设 | 显示精确小数是否掩盖了数据限制? |
| 解释类型 | 描述、关联、预测或因果问题 | 预测或相关是否被直接写成行动依据? |
American Statistical Association 的 p 值声明指出,p 值描述数据与指定统计模型的不相容程度。它不是假设为真的概率,也不衡量效应大小或实际重要性。看到“显著”时,还应检查效应、区间、设计和业务情境。
手工假想算例:组内上升,总体却下降
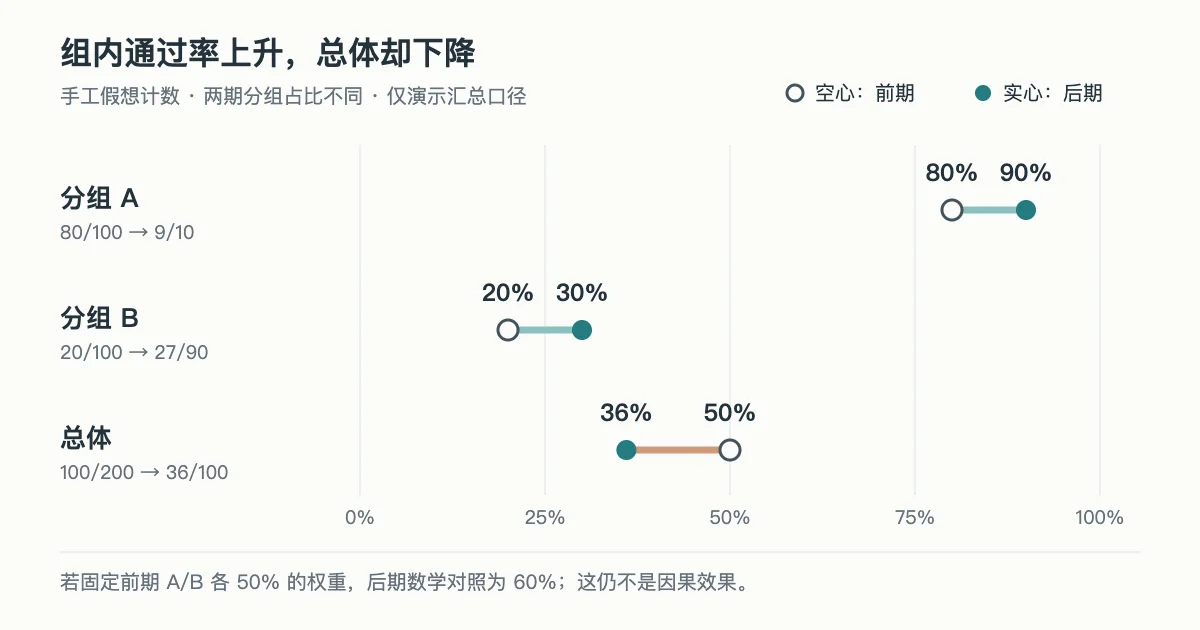
以下是手工编写的假想检查计数,用来展示分母和组别构成怎样影响总体比率。它不来自企业、观察研究或随机试验。A 组前期通过 80 次、检查 100 次,后期通过 9 次、检查 10 次;B 组前期通过 20 次、检查 100 次,后期通过 27 次、检查 90 次。
| 组别 | 前期:通过数 / 分母 = 比率 | 后期:通过数 / 分母 = 比率 |
|---|---|---|
| A 组 | 80 / 100 = 80% | 9 / 10 = 90% |
| B 组 | 20 / 100 = 20% | 27 / 90 = 30% |
| 观察合计 | 100 / 200 = 50% | 36 / 100 = 36% |
A、B 两组的比率都上升,观察到的总体比率却从 50% 降到 36%。原因之一是组别构成改变:前期 A、B 各占一半,后期 B 占九成。若保持前期 A、B 各一半的固定权重,对后期组内比率作数学对照,结果为 (1/2 × 90%) + (1/2 × 30%) = 60%。
用精确分数复算六项断言
本次计算在 Python 3.9.6 中使用标准库 fractions.Fraction,避免小数近似影响断言。下面是可复制的精简复算代码;该版本只打印关键分数,原始运行同时记录了数据来源和限制说明。
from fractions import Fraction as F

before = {"A": (80, 100), "B": (20, 100)}
after = {"A": (9, 10), "B": (27, 90)}

def rate(pair):
    successes, total = pair
    return F(successes, total)

def overall(groups):
    return F(
        sum(pair[0] for pair in groups.values()),
        sum(pair[1] for pair in groups.values()),
    )

weights = {group: F(pair[1], 200) for group, pair in before.items()}
fixed_after = sum(weights[group] * rate(after[group]) for group in before)

assert rate(after["A"]) > rate(before["A"])
assert rate(after["B"]) > rate(before["B"])
assert overall(after) < overall(before)
assert overall(before) == F(1, 2)
assert overall(after) == F(9, 25)
assert fixed_after == F(3, 5)

print(overall(before), overall(after), fixed_after)
实际输出为 1/2 9/25 3/5,六项断言全部符合预期。Python 3.9.6 是本次运行环境记录,不是阅读或复算必须安装的指定旧版本。
总体与分群怎样解释:先回到研究问题
观察总体 36% 并没有算错,组内 90% 和 30% 也没有算错;它们回答的汇总方式不同。若问题是“这段时间全部检查中有多少通过”,观察总体有直接意义;若问题是“相同组别构成下,组内比率变化怎样影响对照”,固定权重结果提供另一种描述。
关于 Simpson 悖论的同行评议论文(NCBI 全文 XML)说明,同一列联数据在不同因果结构下可能需要不同的边际或分层解释。选择总体、分层或标准化比较,需要研究目标、领域知识和因果结构;不能只凭“分组后方向更好”就认定哪个结论应主导决策。
这个假想例没有说明两期人群是否可比、组别为何改变、误差和样本设计、目标人群、干预或混杂结构,也没有记录业务代价。因此,它只能触发口径与数据问题,不能证明改版效果或给出扩大服务的决定。
可填写的业务问题与指标定义卡
- 业务问题:要支持哪项决定,谁使用结果,哪些替代行动也在考虑 __________
- 指标名称:__________
- 分子、分母与单位:__________
- 人群与分群:包括/排除 __________;需要分别查看的组是 __________
- 时间与版本:窗口、时点、数据抽取版本、指标定义变更 __________
- 数据来源与质量:来源、采集/处理、缺失、异常、偏差和文档 __________
- 样本与权重:样本框、样本量、抽样/权重、分层与聚类 __________
- 不确定性:误差范围、关键假设、敏感性和未知 __________
- 解释类型:描述 / 关联 / 预测 / 因果 __________
- 责任与下一证据:谁复核、还需要什么数据或设计、何时更新 __________
阅读统计主张时,可结合科学与思维阅读路线的概念—证据—假设核查卡;企业 AI 试点涉及基线、人工复核和停止条件时,可参考企业 AI 项目价值评估清单。
怎样决定下一本数据决策读物
分子、分母、样本、分布和统计推断说不清,选择《精通统计学》;需要与数据团队讨论分析、模型、项目和团队责任,选择《面向决策者的数据科学》;能够阅读数学模型,准备研究模糊决策、多目标优化或特定领域方法,再选择《智能计算中的决策支持系统》。
先完成一张指标卡或模型阅读卡,再按暴露出的知识缺口逐本组合。书内案例和模型仍需回到当前问题、数据与组织责任中重新核对。
资料范围与验证边界
本文于 2026 年 11 月 9 日核对资料。书目事实来自三本授权 EPUB 的扉页、版权页、前言、目录及必要开篇章节,未完整通读;Harish Garg 是多作者研究集主编。公开资料来自 ASA、ONS、美国 Census Bureau 与一篇 Simpson 悖论同行评议论文。
原创算例只使用手工假想计数和精确分数,运行记录给出分组权重,六项断言核对组内比率、观察总体与固定权重对照的主要算术关系。它没有使用真实客户数据,也没有评估干预、利润、ROI 或项目适用性。