大模型学习路线可以分成六层能力:原理与研究脉络、提示与上下文、检索与工具、智能体运行、评估、权限与生产边界。六层是一张按问题进入的地图,不要求每个人从第一层顺序学到最后一层。想理解模型为什么这样发展,可以从原理开始;正在构建应用,可以从输入、证据和评估契约开始,同时把权限边界写进最初设计。
本文用四本书覆盖这张地图,并标出它们没有解决的部分。每一层都对应一个可以检查的产出:研究问题、上下文契约、工具接口、状态图、评估规则或权限清单。读者可以先完成与当前任务最接近的一项,再决定下一本书和下一层能力。
大模型学习路线:六层能力与最小产出
先写下当前任务,再选择一层作为入口。需要理解论文和架构变化,就从研究脉络开始;需要稳定输出格式,就从上下文与评估开始;需要连接数据或外部动作,就补检索、工具、状态和权限。每层的最小产出可以直接进入下一轮阅读或实现。
| 能力层 | 最小可检查产出 | 对应读物与仍需补足的部分 |
|---|---|---|
| 原理与研究脉络 | 一个架构或研究问题、依据和未解问题 | 《苏茨克维的名单》提供研究思想地图;机器学习基础需另补 |
| 提示与上下文 | 输入、所需上下文、输出格式和上下文边界 | 《基于 DSPy 的上下文工程》覆盖签名、模块、数据集和优化;需按实际版本验证环境 |
| 检索与工具 | 数据来源、工具参数、返回值和失败方式 | 《AI 智能体与执行框架基础》提供工具与 ReAct 入口;检索质量需单独评估 |
| 智能体运行 | 状态、节点、转移、人工审批和外部动作图 | 智能体框架书覆盖 LangGraph 与深度智能体;长程运行仍需实际错误处理 |
| 评估 | 成功条件、输入、证据 ID、预期结果与失败条件 | DSPy 书和安全书均有评估章节;任务语义仍需独立评价 |
| 权限与生产边界 | 数据来源、可调用工具、最小权限、审批与日志需求 | 《企业 AI 智能体安全》提供风险地图;具体系统仍需威胁建模和测试 |
从哪一层开始:原理阅读和应用工程可以有不同入口
如果问题是“Transformer、缩放或推理能力从哪些研究演进而来”,先读原理与研究脉络。如果问题是“回答需要哪些资料、怎样声明未知、如何评估输出”,从上下文与评估开始更直接。如果应用要查询资料、调用工具或持续多步运行,就在同一轮补上检索、状态和权限。
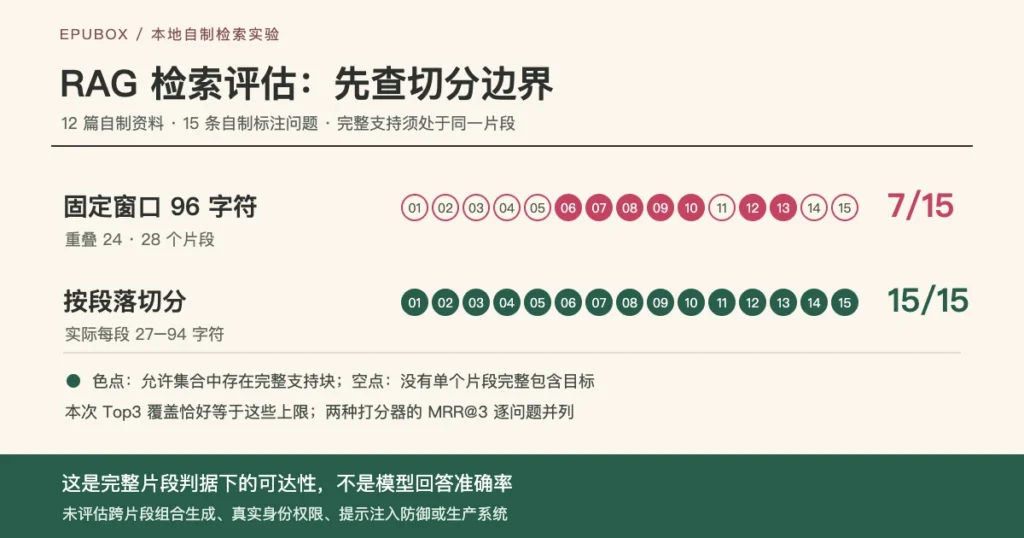
提示词、上下文、RAG、工具调用和智能体运行解决的是不同问题。提示词表达任务;上下文组织推理时可用的信息;检索为当前问题选择外部材料,RAG(检索增强生成)将这些材料纳入生成时的上下文;工具提供受约束的查询或动作接口;智能体运行管理状态、步骤和反馈。评估贯穿这些层,权限则决定哪些数据和动作可以进入系统。
尚未确定自己需要通识、研究还是工程读物时,可以先看人工智能书籍选择路线。本文进一步回答能力怎样拆分,以及读后应产出什么。
大模型书籍:四本书分别覆盖什么
下面的大模型书籍推荐以能力缺口为线索。读者可以选择一册主读,再根据评估、工具或权限方面的具体问题增加补充读物。
大语言模型书籍的原理入口:《苏茨克维的名单》
可核对事实:《苏茨克维的名单:现代 AI 的基础思想》的作者是 Richard Heimann,Sebastian Raschka 撰写序言;Ilya Sutskever 是书中分析对象,不是作者。目录串联 AlexNet、ResNet、RNN/LSTM、Transformer、缩放、推理和安全主题。书内“目标读者”假设基本计算机与数学理解,将它定位为研究思想地图,而非零基础机器学习课程。
编辑判断:如果你想理解现代深度学习研究脉络,可以为每个主题记录三项内容:核心问题、书中引用的研究依据、仍未解决的问题。读后产出是一张研究地图,不需要同时搭建应用。
上下文与评估入口:《基于 DSPy 的上下文工程》
可核对事实:Mike Taylor 的《基于 DSPy 的上下文工程》第一版以 Python、Jupyter、数据集、指标、评估和优化组织工程过程。配套环境支持 Python 3.12–3.14,并固定 DSPy 3.3.0;目录还包括签名、模块、ReAct、检索、生产监控与部署。
编辑判断:如果任务是把输入、上下文、输出格式和评价目标写成可迭代程序,这本书适合作为工程入口。先建立一个小数据集和明确指标,再讨论优化器。DSPy 当前官方文档可用于核对 signatures、modules、tools、metrics 和 optimizers 等概念;本文引用的指标页面属于 DSPy 3.4.0 文档,只作评估概念参照,不证明书内 3.3.0 示例已经兼容当前版本。
LLM书籍的智能体实现入口:《AI 智能体与执行框架基础》
可核对事实:《AI 智能体与执行框架基础》的作者是 Eden Marco;Iago Cavalcante 与 Muhammad Awais 是审稿人。目录从项目设置和 LangChain 基础进入本地模型、工具调用、ReAct、LangGraph、上下文、状态、深度智能体与安全。完成相应示例需要编程、环境配置和工具或 API 基础。
编辑判断:如果你已经能定义任务和输出,下一步需要把工具、状态和多步运行连接起来,可以从工具、ReAct 与 LangGraph 章节开始。读后画出节点、边、共享状态、失败路径和人工审批位置。LangGraph 官方“Thinking in the Graph API”页面使用 JavaScript 示例,本文只借用节点、边与状态的概念,不将其代码签名当作 Python 或其他版本的兼容依据。
权限与生产边界入口:《企业 AI 智能体安全》
可核对事实:Thomas De Vos 的《企业 AI 智能体安全》目录覆盖授权与权限、提示注入、MCP、身份、最小权限、工具保护、评估、可观测性、可靠性和 RAG 攻击面。
编辑判断:当应用开始接触企业数据、API 或高影响动作时,这本书适合用来建立风险与控制清单。读后可整理数据来源、工具权限、审批、输出校验和日志需求。OWASP 的提示注入说明区分直接与间接注入,并将外部内容视为攻击面;最小权限、输出校验和高影响动作确认用于降低影响。
上下文、工具和智能体:先画数据与动作边界
上下文工程管理推理时可用的信息,不只是改写一句提示词。Anthropic 在 2025 年 9 月 29 日发布的智能体上下文工程文章讨论了系统指令、工具、外部数据和消息历史的迭代管理。这是带明确日期的厂商工程观点,可以帮助整理上下文组成,但不应当作所有框架当前版本的统一规范。
应用设计时可以先画两条线:数据线记录输入、检索材料、消息历史与输出;动作线记录工具参数、权限、返回值、失败和人工确认。这样能看出“模型需要知道什么”和“系统允许做什么”之间的差别,也方便为评估准备固定输入与证据 ID。
离线评估契约练习:先验证结构,再评价语义
下面的练习使用 Python 3.9.6 标准库和五组手工预设回答,不调用模型、网络或外部工具。它检查四个必填字段、字段类型、证据 ID 是否存在,以及声明未知时的回答形状。练习演示的是“先定义契约再运行断言”,不是 DSPy 程序或模型质量测试。
输入与规则:回答、证据 ID、未知项与不作答标记
"""Hand-written fixtures; no model, retrieval, network, or external tool call."""
import json
import sys


def check_response(reply, provided_ids):
    required = {"answer", "evidence_ids", "unknowns", "abstain"}
    if not isinstance(reply, dict):
        return False, "not-an-object"
    missing = sorted(required - reply.keys())
    if missing:
        return False, "missing:" + ",".join(missing)
    if not isinstance(reply["answer"], str) or type(reply["abstain"]) is not bool:
        return False, "invalid-answer-or-abstain-type"
    for field in ("evidence_ids", "unknowns"):
        values = reply[field]
        if not isinstance(values, list) or not all(isinstance(x, str) for x in values):
            return False, "invalid-list:" + field
    if reply["abstain"]:
        valid = not reply["answer"].strip() and not reply["evidence_ids"] and bool(reply["unknowns"])
        return valid, "abstain-shape" if valid else "invalid-abstain-shape"
    if not reply["answer"].strip() or not reply["evidence_ids"]:
        return False, "answer-needs-evidence-ids"
    if set(reply["evidence_ids"]) - set(provided_ids):
        return False, "unknown-evidence-id"
    return True, "shape-ok"


context = {
    "ref:goal": "Define the success criteria before optimizing a program.",
    "ref:limit": "An existing reference ID does not prove semantic support.",
}
base = {
    "answer": "Define success criteria first.",
    "evidence_ids": ["ref:goal"],
    "unknowns": [],
    "abstain": False,
}
missing = {key: value for key, value in base.items() if key != "unknowns"}
cases = [
    ("valid_structure", base, True, "shape-ok"),
    ("unknown_reference", {**base, "evidence_ids": ["ref:absent"]}, False, "unknown-evidence-id"),
    ("missing_field", missing, False, "missing:unknowns"),
    (
        "explicit_unknown",
        {"answer": "", "evidence_ids": [], "unknowns": ["No answer in context"], "abstain": True},
        True,
        "abstain-shape",
    ),
    # Deliberately wrong: the context does not support this answer.
    (
        "unsupported_semantics",
        {**base, "answer": "This test called an online language model."},
        True,
        "shape-ok",
    ),
]

results = []
for name, reply, expected, expected_reason in cases:
    passed, reason = check_response(reply, context.keys())
    assert (passed, reason) == (expected, expected_reason), name
    results.append({"case": name, "structure_passed": passed, "reason": reason})

print(json.dumps({
    "python_version": sys.version.split()[0],
    "fixture_source": "hand-written",
    "model_calls": 0,
    "results": results,
    "limit": "unsupported_semantics passes structure; semantic support still needs a separate evaluation",
}, indent=2))
运行练习:五个断言符合预期
将代码保存为 evidence_contract.py,在 Python 3.9.6 中运行 python3 evidence_contract.py。程序完成五项断言:两个结构合格样本通过,未知证据 ID 或缺少字段的两个样本按预期拒绝,另一个语义错误样本仍通过结构检查。
| 输入类别 | 结构检查 | 原因 |
|---|---|---|
| 合格结构 | True |
字段、类型和证据 ID 结构符合规则 |
| 未知引用 ID | False |
引用了允许集合中不存在的 ID |
| 缺少字段 | False |
缺少必填的未知项字段 |
| 明确未知 | True |
声明不作答时,回答和引用留空,并列出未知项 |
| 语义错误反例 | True |
故意错误的回答仍满足结构,暴露规则边界 |
结果边界:结构与引用存在不等于语义支持
unsupported_semantics 声称“本测试调用了在线语言模型”,但预设上下文并不支持这句话。它仍通过,因为规则只检查字段、类型和证据 ID 是否存在,没有判断证据内容是否支持答案。真实应用需要另设语义评价、标注比较或其他任务质量检查。
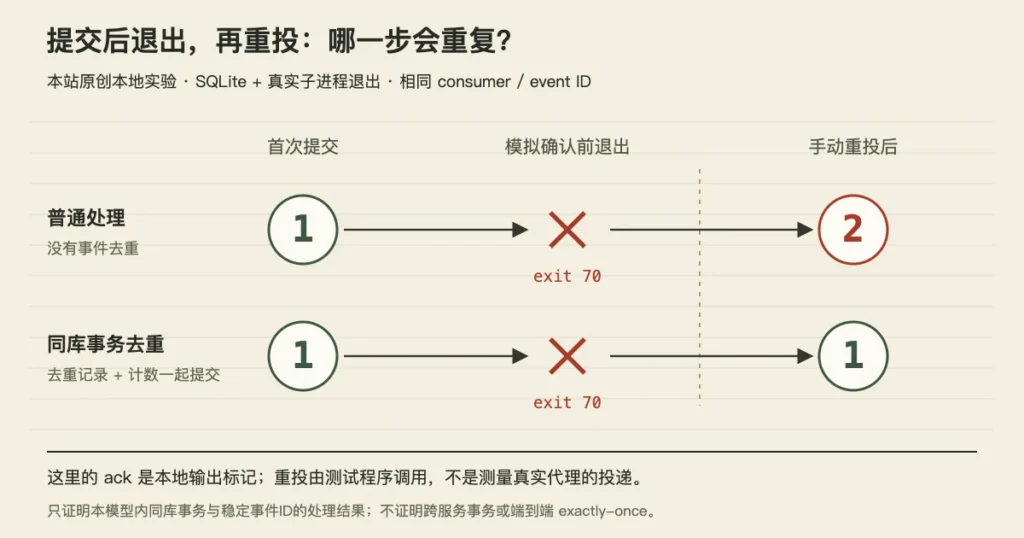
这五项断言只证明规则程序按预期接受或拒绝手工样本。它没有调用 LLM、检索、RAG、网络或工具动作,也没有测试提示注入抵抗力、框架兼容性或生产系统表现。这里的 Python 3.9.6 练习与《基于 DSPy 的上下文工程》所用 Python 3.12–3.14、DSPy 3.3.0 环境彼此独立。
为什么评估与权限要在学习早期出现
没有成功条件,提示和上下文很难比较;没有权限边界,工具调用的影响也无法界定。因此,在第一次练习中就可以记录:输入从哪里来、允许引用哪些证据、输出必须有哪些字段、何时声明未知、允许调用哪些工具、哪些动作需要确认、发生错误后保留哪些日志。
DSPy 指标文档区分规则检查、与标注数据比较和模型评判等评估方式。离线契约属于规则检查,只覆盖预先写出的条件。进入模型或检索任务后,应根据真实问题增加语义、相关性、完整性和失败情形的评价。
可填写的能力与证据工作单
- 当前任务:我要解释、生成、检索、调用工具或完成的工作是 __________
- 能力层:当前主要缺口属于原理、上下文、检索/工具、智能体、评估或权限 __________
- 输入与来源:输入、上下文、数据和证据 ID 来自 __________
- 输出契约:必填字段、格式、声明未知与报错时的字段组合是 __________
- 评价方法:规则、标注数据、人工复核或其他任务质量检查 __________
- 工具与权限:允许调用 __________;需要人工确认的动作是 __________
- 版本:语言、框架、模型、依赖和文档日期 __________
- 当前空白:这次练习仍未验证 __________
- 下一项产出:我将补充的样本、状态图、权限清单或评估是 __________
开始读 EPUB 前,可按EPUB 电子书阅读方法检查目录、代码与导航;涉及 Python、DSPy、LangChain 或 LangGraph 时,可用技术书籍的版本与前置知识核对方法分开记录书内环境和当前官方文档。
怎样选择下一本大模型读物
研究论文和架构脉络说不清,选择《苏茨克维的名单》;需要把上下文、数据集和指标组织成程序,选择《基于 DSPy 的上下文工程》;需要理解工具、状态和智能体循环,选择《AI 智能体与执行框架基础》;应用已接触企业数据、API 或外部动作,选择《企业 AI 智能体安全》补权限与风险地图。
读完指定章节后,先完成一个最小产出,再决定是否补另一册。寻找更广泛的生成式人工智能书籍时,也可以沿用同一方法:先写能力缺口和可检查产出,再看目录是否真正覆盖它。
资料范围与验证边界
本文于 2026 年 11 月 9 日核对资料。书目事实来自四本授权 EPUB 的扉页、版权页、前言、目录及必要开篇章节,未完整通读,也未运行书内项目。公开资料来自 DSPy、LangGraph、Anthropic 与 OWASP;Anthropic 文章日期为 2025 年 9 月 29 日,LangGraph 来源为 JavaScript 文档页。
实际运行部分只有 Python 3.9.6 标准库的离线规则练习,使用五个手写样本,模型调用数为 0。结果证明结构契约按预期执行,不代表 LLM、RAG、框架兼容性、提示注入防护或生产安全表现。