人工智能搜索优化书籍应按基础与证据能力来选:还不会核对页面技术、内容与测量时,先补传统 SEO;已经能做单页审计,再学习 AI 搜索基线和引用记录;需要把内容、公关与组织协作放进 GEO 战略时,才进入更综合的读物。三本书不必一起买,也没有一本书能保证页面被 AI 回答引用。
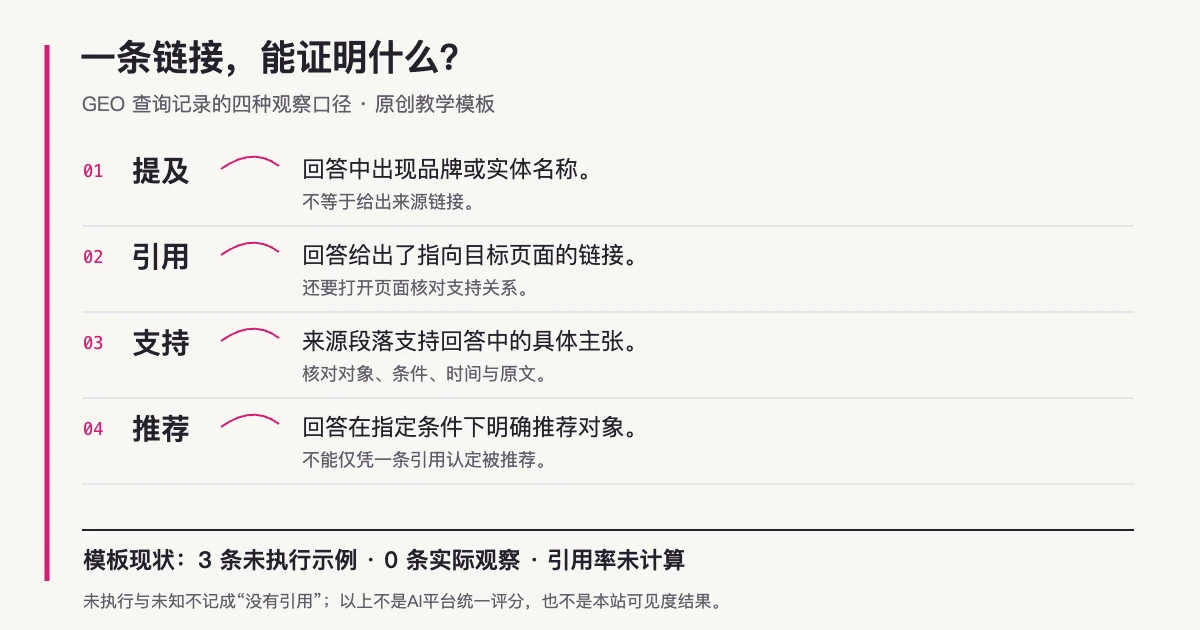
这条路线区分四类材料:Google 官方要求说明其自有搜索功能的现行边界;原始论文说明特定实验怎样设计;书籍提供作者框架和案例;本站模板只提供未来观察的记录格式。被提及、出现链接、来源支持回答、被明确推荐,是四件不同的事;其中任一项也不等于用户信任或成交。
人工智能搜索优化书籍:先匹配任务与证据
| 阅读任务 | 章节入口 | 可核查产出 |
|---|---|---|
| 补传统基础 | 《SEO 艺术》5–10 章:策略、关键词、技术、测量与审计 | 页面问题、官方依据、修正与复查记录 |
| 建立 AI 观察 | 《人工智能搜索引擎优化实战指南》1–8 章:术语、基线、追踪与实验 | 查询条件、原始回答、引用与未知项 |
| 延伸站内证据 | 《AI SEO》9–15 章:主题、审计、HTML、页面与媒体 | 可见主张、来源段落与页面实现核对 |
| 制定 GEO 战略 | 《生成式引擎优化》1–9 章:测量、内容、公关、案例与组织 | 待验证假设、责任人、观察范围与停止条件 |
传统技术与审计底座:《SEO 艺术(第四版)》
Eric Enge、Stephan Spencer、Jessie Stricchiola 合著的《SEO 艺术(第四版)》适合建立搜索策略、关键词、技术、测量与审计的完整地图。它从初学者基础逐步进入更复杂任务;2023 年出版语境中的平台界面、算法案例和生成式产品术语,需要用当前官方资料复核。
如果还不能独立记录 HTTP、canonical、标题、正文、链接和结构化数据等页面证据,可先参考搜索引擎优化书籍选择与单页审计方法,再决定是否进入 AI 搜索观察。
AI 搜索基线与记录:《人工智能搜索引擎优化实战指南》
Nathan Gotch 的《人工智能搜索引擎优化实战指南》以传统 SEO 为基础,目录从指标、仪表板、竞争观察和实验,延伸到站内审计、品牌、提及、引用与治理。它适合已经运营或协助改善网站,希望把 AI 搜索观察变成可重复记录的读者。
书中的覆盖、位置、声量和引用属于作者的工作框架,不能直接当作 Google 或所有 AI 平台的统一指标。阅读时应把平台入口、日期、查询、回答和实际来源一起保存,而不是只截取一个“被引用”画面。
生成式引擎优化入门:《生成式引擎优化》
Ross Hudgens 的《生成式引擎优化:AI SEO 权威指南》把 GEO 建立在传统 SEO 之上,讨论生成式引擎、测量、策略、内容、数字与效果公关、案例和组织协作。它更适合已经具备 SEO 背景,准备研究内容与第三方信号如何形成待验证假设的读者。
书中的工具截图、行业案例和作者策略观点是阅读材料,不是 Epubox 的引用结果,也不能证明外部平台目前采用相同检索机制。案例可转成观察问题,再按明确条件收集证据。
GEO与SEO阅读路线:官方要求、论文与书不能混用
Google AI features 仍以普通 SEO 为基础
Google 的AI features 指南说明,AI Overviews 和 AI Mode 沿用现有 SEO 实践,没有额外技术要求或特殊优化。页面要成为 supporting link,需要已被 Google 索引、具备显示 snippet 的资格并满足常规技术要求;抓取、索引和展示仍不保证。
这支持“先把普通 SEO 和可见内容做好”的阅读顺序,不支持固定段落长度、关键词密度、llms.txt 或新增某类 schema 就能获得引用。它只说明 Google 所述功能,不能推广为其他 AI 平台的统一机制。若仍在选择搜索、视频或其他营销渠道,可先看数字营销电子书路线。
GEO 论文观察的是受控实验,不是当前线上预测
Aggarwal 等人的 GEO: Generative Engine Optimization 提出 GEO-bench,以及 Position-Adjusted Word Count 和 Subjective Impression 等研究型可见度指标。主实验采用研究者构造的两步引擎:取 Google 前五个来源,再由 gpt-3.5-turbo 为每条查询采样五个回答;数据集包含 10,000 条查询。另一个 Perplexity 实验对 200 个样本上传来源文件,回答受这些文件限制。
这些指标衡量论文设置中的引用文字、位置和主观印象,不是 Search Console 流量、搜索排名、营收或通用 AI 可见度分数。论文也说明引擎与查询会变化,并未评估 GEO 方法对传统排名的影响。因此,论文结论不能直接预测当前中文公开网页、本站页面或任一现行平台的结果。
AI搜索内容证据要求:有链接还要核对支持关系
一次观察至少要回答四个问题:
- 提及:回答正文是否出现目标品牌或实体名称?
- 目标引用:回答是否真的链接到预先定义的目标页面?
- 来源支持:打开实际引用 URL 后,哪一段能够支持提取出的回答主张?
- 推荐:回答是否在明确条件下建议使用该产品或页面,而不只是列出名称?
Google 的结构化数据指南要求标记真实代表页面可见内容,正确实现也不保证 rich result。对编辑核查而言,schema 存在、得到普通网页入链或被回答提到品牌,均不能单独证明目标页在某次 AI 回答中被作为来源引用;即使有实际引用,仍要检查源文是否支持对应主张。
AI搜索引用评估方法:保留条件、原答和来源段落
本站准备的 CSV 模板共有 22 列,可按四组理解:
| 记录组 | 实际字段示例 | 填写规则 |
|---|---|---|
| 查询条件 | query_text、platform、product_surface、search_mode、model_display、locale |
原样记录;不可见值保留 unknown |
| 会话与时间 | session_context、captured_at_utc、evidence_ref |
联网状态可写入会话说明或备注;保留原始证据位置 |
| 回答与来源 | answer_claim、observed_citation_url、source_supporting_passage、support_verdict |
先提取主张,再打开实际链接核对原文 |
| 观察结果 | brand_mention、target_citation、recommendation、status |
分别判断;未运行不能记作 no |
其中一条预备问句是“如何选择一本适合自己的SEO入门书?”,candidate_target_url 预先填入本站 M02 页面。这个字段只表示未来想观察的候选目标,不表示回答已经引用它。该行目前仍为 status=not_run,平台、搜索模式、模型显示与 locale 均为 unknown,回答、引用、支持段落和证据字段为空。
模板目前有 3 条预备问句、0 次实际观察、0 次已评估引用,引用率保留为 null(未计算),不产生比例结果。如果以后执行,同一查询的每次重跑都应保留独立记录;只能报告“在相同定义下的已核样本中 X/Y”,不能把前后变化自动解释为某次内容修改造成的效果。
怎样决定下一本书
- 页面技术、内容与审计证据还不会核对:先读《SEO 艺术》,建立传统基础。
- 已有基础,准备记录平台、查询、回答、引用和缺失项:读《人工智能搜索引擎优化实战指南》。
- 已经能区分观察与因果,希望研究内容、公关和组织层面的 GEO 假设:再读《生成式引擎优化》。
本文核对了三本授权 EPUB 的扉页、版权信息、前言、目录与必要章节,没有完整通读全书。本站 CSV 是未执行的编辑模板,没有运行真实 AI 查询、付费监测或引用实验,也没有产生提及、引用、支持或推荐结果。